Amazon TranscribeでCustom vocabulary登録時にエラー
Amazon Transcribeで文字起こしの精度を上げるために、固有名詞をCustom vocabularyに登録したいと思うことがあると思います。
しかし、そこで予期せぬエラーが発生したのでメモ書きを残しておきます。
登録に使ったファイルはテーブル形式の以下のデータです。
Phrase[tab]IPA[tab]SoundsLike[tab]DisplayAs
てすとかぶしきがいしゃ[tab][tab][tab]テスト株式会社
Create vocabularyから各種設定を行い作成しました。

そうすると以下のエラーメッセージが表示されました。
The vocabulary that you’re trying to create contains invalid characters or incorrectly formatted terms. See the developer guide for more information.
色々と調べていたところ、理由は説明資料に書かれておりました。
https://docs.aws.amazon.com/ja_jp/transcribe/latest/dg/transcribe-dg.pdf
Amazon Transcribe コンソールを使用してカスタム語彙をアップロードする場合は、語彙テーブ
ルの代わりに語彙リストを使用する必要があります。コンソールを使用してカスタム語彙を語彙
テーブルで作成するには、ソースファイルが Amazon S3 バケットに存在する必要があります。
つまり、
テーブル形式のCustom vocabularyを登録する場合はS3を利用すること。
リスト形式の場合は「File upload」、「S3 location」のどちらでも登録できました。
RailsのサイトにMauticを導入する方法
 Railsで作られたアプリケーションにMauticを導入してマーケティングオートメーションの環境を構築する方法について説明する。
Mauticとは?
https://jp.mautic.org/
Google アナリティクスのようにWebサイトへのアクセスデータを収集し、ユーザの行動からメール等でコンタクトを取ることができるようになる。
SalesforceなどCRMとの連携はプラグインがあるため簡単に連携できるが、RailsなどカスタムサイトはAPI経由で連携する必要があるため、その方法を記載する。
Mauticサーバの立ち上げ
- Dockerを利用して立ち上げ
Dockerfile
version: '3'
services:
  ma:
    image: mautic/mautic
    volumes:
      - mahtml:/var/www/html
    ports:
      - "8081:80"
    links:
      - madb:mysql
    environment:
      - MYSQL_ROOT_PASSWORD=password
  madb:
    image: mysql:5.6
    volumes:
      - madata:/var/lib/mysql
    environment:
      - MAUTIC_DB_HOST=madb:3306
      - MAUTIC_DB_USER=root
      - MAUTIC_DB_PASSWORD=password
      - MAUTIC_DB_NAME: mauticdb
volumes:
  mahtml:
    external: true
  madata:
    external: true
- Mauticサーバ起動
docker-compse up
- Mautic(http://localhost:8081)にアクセス
- 画面に従ってインストール
Mauticの設定
- APIの有効化
Mauticにログイン後、設定画面から「API Settings」メニューを選択し、「API enabled?」をONに変更する。

- API Credentialsを新規作成
Redirect URIはhttp://localhost:8080/mautic/connections/:ID/oauth2を指定する。
ID:Rails側のmautic_connectionsテーブルに追加したレコードのIDであり、ひとまず"1"を設定する。
- カスタムフィールド追加
RailsのUser IDを設定するためのカスタムフィールドを追加する。
Label=user_id, Object=Contact
Railsの設定
- Gemfileに以下の行を追加
gem 'mautic'
- Mauticをインストール
bundle install
- config/routes.rbに以下の行を追加
mount Mautic::Engine => "/mautic"
- config/initializers/mautic.rbを作成
Mautic.configure do |config|
  # This is for oauth handshake token url. I need to know where your app listen
  config.base_url = "http://localhost:8080"
  # *optional* This is your default mautic URL - used in form helper
  config.mautic_url = "http://localhost:8081"
end
- DBにMautic接続用のテーブル追加
rake db:migrate
- データを追加(作成した際に自動採番されるIDがMauticの管理画面で必要となる)
Mautic::Connection.create(type: 'Mautic::Connections::Oauth2', url: 'http://localhost:8081', client_id: '1_637m4pv6tqg4kwcw88oo8ckggg4s8wcc8ww8w000gso8oo4og8', secret: '4iq54rrzot2c0sg4kk4s0g0k0k0oo0gw44owckokg8w8ks44c0')
localhost:8081はMauticサーバだが、Docker環境で動かしているとコンテナ内にアクセスしてしまうため、Mauticサーバにアクセスできない。
linkを利用するように設定し、url:'http://ma'のような感じでデータを登録する必要がある。
RailsとMautic間でユーザ情報連携
Railsに登録されたユーザをMauticに連携する。
* MauticのタグをRailsに埋め込む
Mauticの設定画面からタグを出力し、app/views/layouts/application.html.erbに貼り付ける
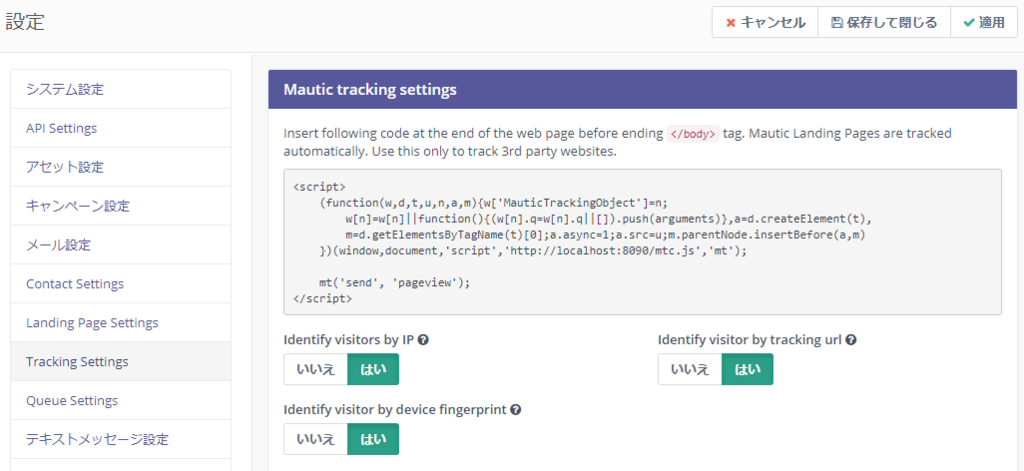 ※GTMでもよい
- 埋め込んだタグを一部修正
ユーザがログイン状態のときは、Railsのユーザ情報をMauticに送信する
あとでRailsからユーザ情報を連携する際の検索条件に利用する
mt('send', 'pageview', {'user_id': '<user.id>', 'email': '<user.email>' })
- バッチ等でRailsからMauticへユーザ情報を連携 user_idまたはemailを検索キーとしてMauticから情報を取得し、Railsのデータで名前等の個人情報を補完し、Mauticに保存する
# Mauticに接続する
conn = Mautic::Connection.last

# 実際はallではなく条件を絞り込んだほうがよい
User.all.each do |user|
  # ucdまたはemailが一致しているデータをMauticへ連携する
  contact = conn.contacts.where(search: "user_id: #{user.id}").first
  contact = conn.contacts.where(search: "email: #{user.email}").first if contact.blank?

  # ユーザ情報を格納する
  contact.firstname = user.first_name
  contact.lastname = user.last_name

  # ユーザ情報をMauticに保存する
  if contact.save then
    Rails.logger.info('success')
  else
    Rails.logger.error("error: #{contact.errors}")
  end
end
エラー対応
- データを取得しようとすると404エラーが発生する
Mautic::RecordNotFound: 404 エラーに遭遇したようです (エラー #404)。もし同じことが起こったらシステム管理者に通報してください。
Mauticサーバのログは200で正常に返っている場合、キャッシュに問題があるため削除する。
rm -rf app/cache/*
あとキャッシュディレクトをWeb rootディレクトリ以外に変更する。

- AWS ELBを利用しSSL経由でアクセスすると一部のURLでhttpが使われる
ELBにSSLを設定してアクセスした場合、外部からは443ポートでアクセスできるが、EC2側は80ポートでアクセスされる。
そのため、mtc.jsのURLが"http://www.hogehoge.com/mtc.js"になってしまいブラウザでエラーが発生する。
回避方法としてMauticのコードを一部修正する。
修正ファイル:/var/www/html/index.php
以下の行を追加する
if (isset($_SERVER['HTTP_X_FORWARDED_PROTO']) && $_SERVER['HTTP_X_FORWARDED_PROTO'] === 'https') {
    $_SERVER['HTTPS'] = 'on';
}
今すぐ安価で始められる機械学習環境の構築
- 試しに機械学習のプログラムを動かしてみたい
- 機械学習をするためにGPUがあれば高速に学習できるが、値段が高いから躊躇してる
という方におすすめ
超高速なGPUで機械学習のプログラミングができる環境を、月々3,828円で構築する手順
利用するインスタンス
AWS EC2 p3.2xlarge
搭載しているGPUはNVIDIA Tesla V100 販売価格126万 ※http://www.gdep.co.jp/products/list/v/59ce00a4ee5f6
月々の料金
3,828円
月々20日、1日2時間利用を想定
スポットインスタンスの金額 $0.87(2017/12/3時点)
20日 x 2時間 x $0.87 x 110円 = 3,828円/月
構築手順
EC2インスタンス立ち上げ
通常のインスタンスを作成する
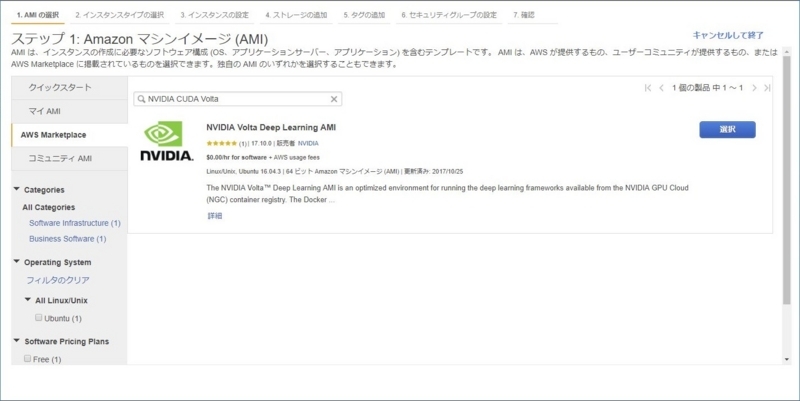 「NVIDIA Volta Deep Learning AMI」を選択する
このイメージはnvidia-dockerがデフォルトで入っているため、環境構築が簡単
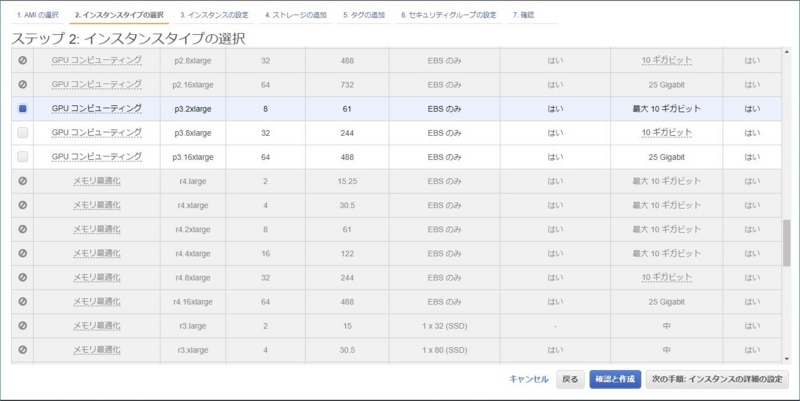 「NVIDIA Volta Deep Learning AMI」を選択している場合、p3系しか選択できなくなる
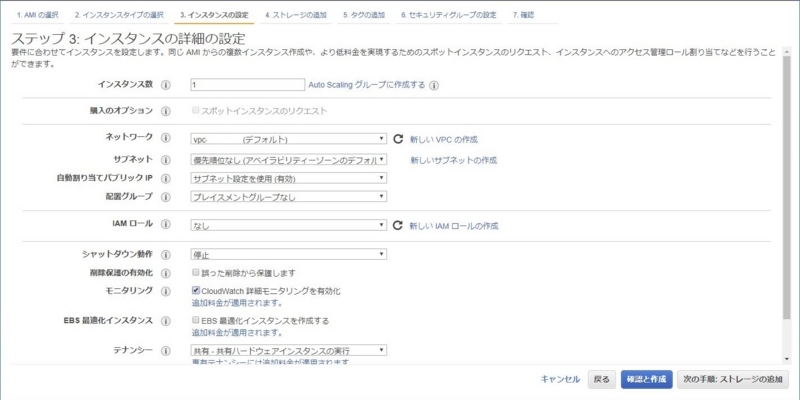 特に必要なければデフォルトで問題ない
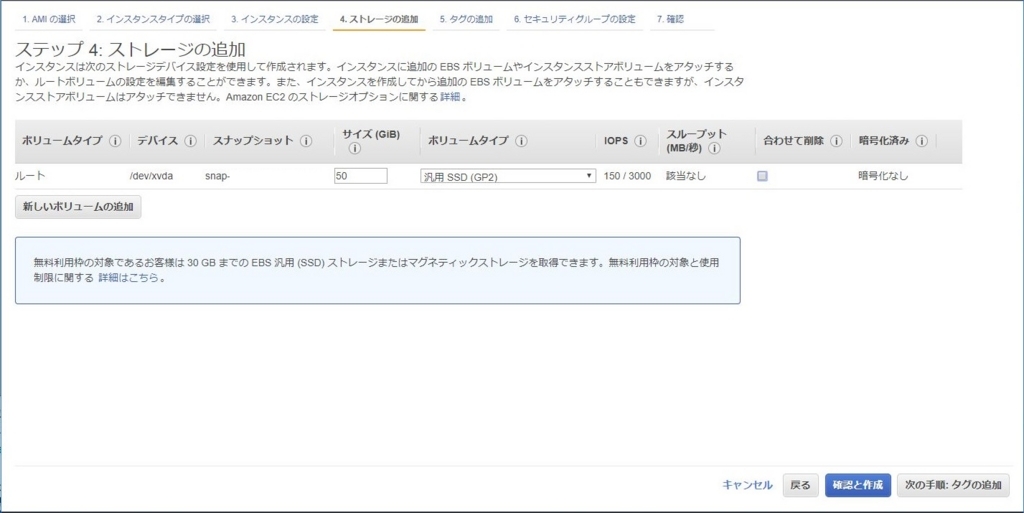 種類や容量は好きなように設定する
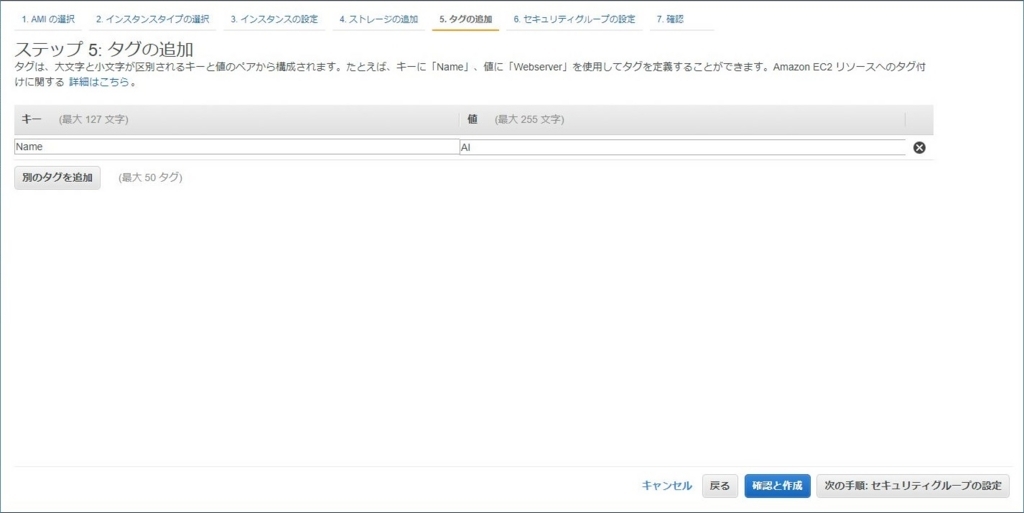 特に指定は無いが、わかりやすいようにAIとしている
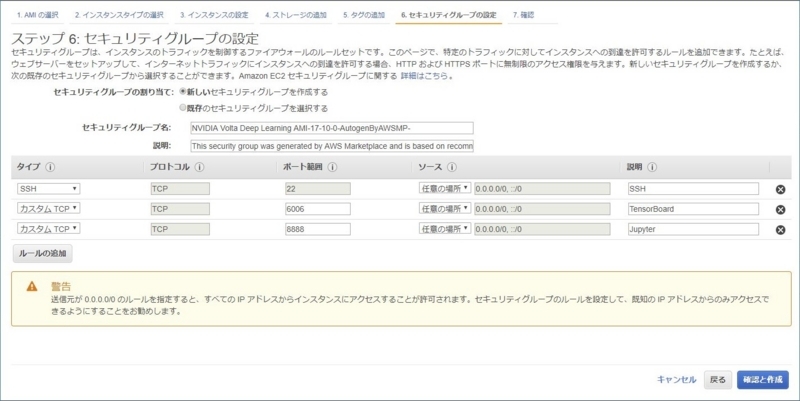 Jupyterは8888ポート、TensorBoardは6006ポートを利用する
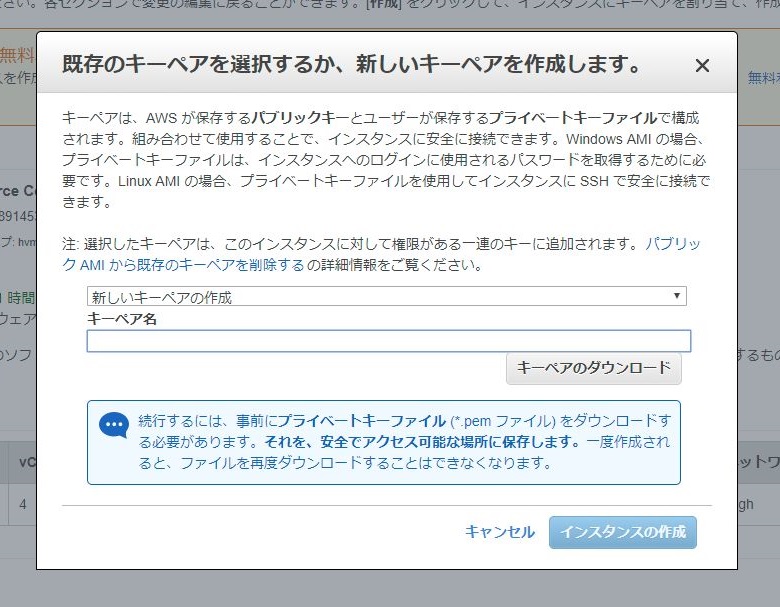
機械学習環境構築
SSHでEC2にログイン
ユーザ名:ubuntu
SSHキー:xxx.pem(EC2の構築で設定したキーペア)
日本時間に変更
$ sudo ln -sf /usr/share/zoneinfo/Asia/Tokyo /etc/localtime
アップデート
$ sudo apt update -y
$ sudo apt upgrade -y
機械学習の設定が済んでいるDockerイメージを作成
1.5時間近く作成に時間がかかる
※DockerfileでOpenCV系を除外すれば早くなる
$ git clone https://github.com/masakiz/tensorflow.git
$ cd tensorflow
$ nvidia-docker build --no-cache --rm -t masakiz/tensorflow:latest .
Dockerイメージを起動
$ cd /home/ubuntu/tensorflow
$ mkdir -p notebooks/logs
$ nvidia-docker run --name tensorflow -p 6006:6006 -p 8888:8888 -v $PWD/notebooks:/notebooks -e LOGDIR=/notebooks/logs -e LANG=ja_JP.UTF-8 --device=/dev/fuse:/dev/fuse --privileged masakiz/tensorflow:latest
でJupyterにアクセスできれば完了
機械学習の開発環境が整う
【オプション】S3フォルダをマウントする
goofysをインストール
$ sudo add-apt-repository -y ppa:longsleep/golang-backports
$ sudo apt-get update
$ sudo apt-get install -y golang-go
$ export GOPATH=/home/ubuntu/work
$ go get github.com/kahing/goofys
$ go install github.com/kahing/goofys
AWSの設定
$ sudo apt-get install -y python python-pip
$ sudo pip install awscli
$ aws configure
AWS Access Key ID [None]: AKIAIOSFODNN7EXAMPXX
AWS Secret Access Key [None]: wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKXX
Default region name [None]: ap-northeast-1
Default output format [None]: json
S3フォルダマウント
$ mkdir /home/ubuntu/tensorflow/notebooks/workspace
$ chown -R ubuntu:ubuntu /home/ubuntu/tensorflow/notebooks
$ sudo /home/ubuntu/work/bin/goofys -o allow_other --uid 1000 --gid 1000 --region ap-northeast-1 <S3のバケット名> /home/ubuntu/tensorflow/notebooks/workspace
AMIイメージを作成
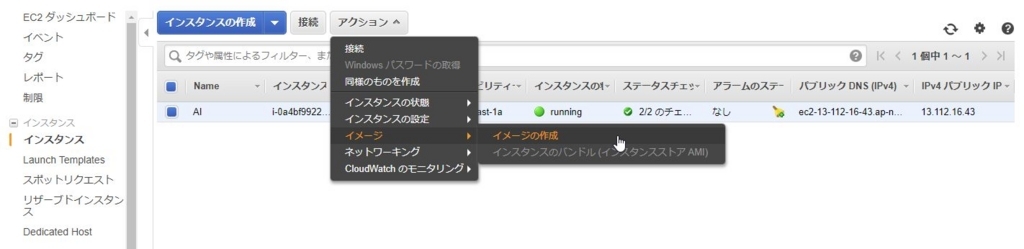 作成したAIインスタンスを選択し、「アクション」→「イメージ」→「イメージの作成」を選択する
作成する前にインスタンスを停止しておいたほうがよい
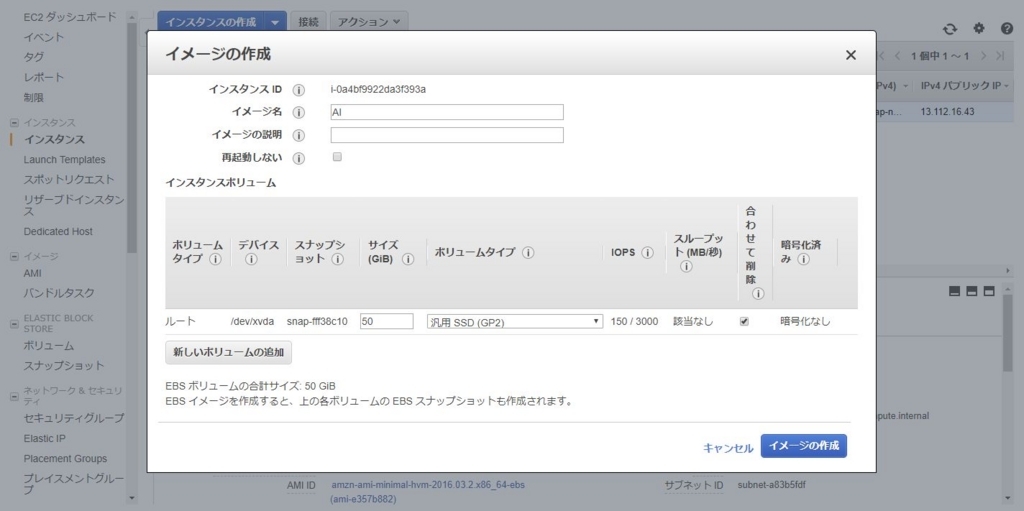 イメージ名やイメージの説明を入力して作成
これも1時間以上時間がかかる
イメージの作成が完了したら、EC2インスタンスは削除してよい
※そのままにしておくと、通常のレートでどんどん課金されていくので注意
スポットインスタンスの設定
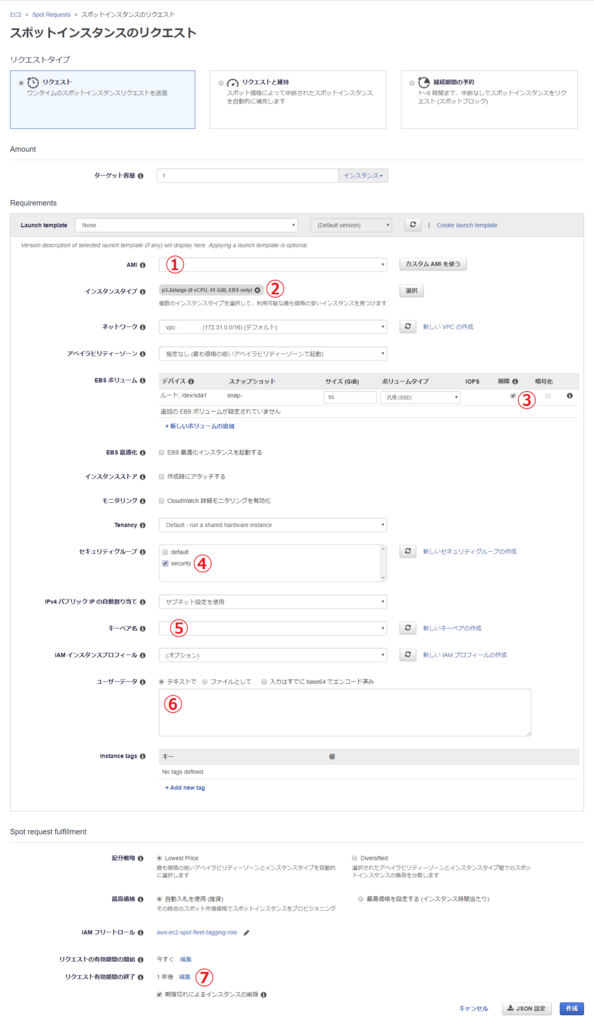
① 作成したAMIイメージを選択
② インスタンスタイプは機械学習環境構築で使ったp3.2xlargeを選択
③ EBSボリューの削除にチェック
④ セキュリティグループは機械学習環境構築で設定したセキュリティグループを選択
⑤キーペアは機械学習環境構築で設定したキーペア名
⑥インスタンス起動時にコマンドを実行させたい場合は、ここにシェルを記載(#!/bin/shから始める)
起動時にjupyterも同時に起動しておくことも可能
⑦リクエスト有効期間の終了は24時間に設定するなどしてスポットインスタンス停止忘れ防止
KotolinとDeeplearning4jで日本語解析入門
概要
KotolinとDeeplearning4jで日本語を解析し、カテゴライズ化する。
やりたいこと
文章で書かれたデータはそのままでは分析に利用しづらい。
その為、文章から様々な属性を抽出してカテゴライズする。
処理結果
データ総数: 5,506件
トレーニング:80%
テスト:20%
20未満、20代、30代、40代、50代、60以上で分類
精度31%
プログラム
形態素解析
構文解析にkuromojiを利用する。
    val tokenizer = Tokenizer()
    val wordSequenceMap = hashMapOf<String, Int>()
    var sequence = 0
    val wordX = csvX.map { x ->
        tokenizer.tokenize(x).map { info ->
            val word = info.getSurface()
            if (!wordSequenceMap.contains(word))
                wordSequenceMap.put(word, sequence++)
            word
        }
    }
    val sequencesX = wordX.map { x -> x.map { word -> wordSequenceMap.getOrDefault(word, 0).toFloat() } }
    val fillZeroX = sequencesX.map { x -> x + Collections.nCopies(maxWordNum - x.size, 0.0f) }
LSTM
簡略化のため、LSTM一層で構成されたモデルを作成
    val conf = NeuralNetConfiguration.Builder()
            .seed(seed)
            .iterations(iterations)
            .optimizationAlgo(OptimizationAlgorithm.STOCHASTIC_GRADIENT_DESCENT)
            .list()
            .layer(0, GravesLSTM.Builder()
                    .nIn(maxWordNum)
                    .nOut(lstmLayerSize)
                    .activation(Activation.TANH)
                    .build())
            .layer(1, RnnOutputLayer.Builder(LossFunctions.LossFunction.MCXENT)
                    .nIn(lstmLayerSize)
                    .nOut(outputNum)
                    .weightInit(WeightInit.XAVIER)
                    .activation(Activation.SOFTMAX)
                    .updater(Updater.RMSPROP)
                    .build())
            .backprop(true).pretrain(false).build()

    val model: MultiLayerNetwork = MultiLayerNetwork(conf)
    model.init()
    model.setListeners(Arrays.asList(ScoreIterationListener(listenerFreq) as IterationListener))
ソースコード
資料
どこでもKotlinで発表した際の資料
